Самая неприятная ошибка резервного копирования — та, о которой узнают во время восстановления. Поэтому мониторинг бэкапов должен проверять не «есть ли файл», а всю цепочку: задание стартовало, завершилось успешно, создало свежую копию ожидаемого размера, хранилище доступно, а данные периодически удаётся восстановить.
Минимальный набор метрик
- время последнего успешного бэкапа;
- размер последней копии;
- код завершения backup job;
- свободное место в целевом хранилище;
- длительность задания;
- резкий рост или падение размера;
- результат последнего теста восстановления.
Лучше передавать в Zabbix результат самого backup job
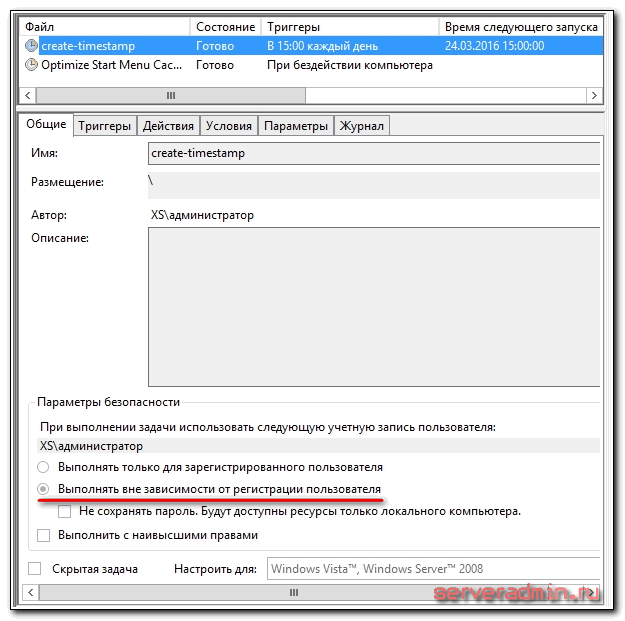
В старой Windows-схеме backup-скрипт запускался через Task Scheduler даже без интерактивного входа пользователя. Это по-прежнему важная проверка: задача должна выполняться независимо от того, кто вошёл в систему.
Если ваш скрипт или программа резервного копирования умеет вернуть exit code, дату и статистику, используйте их. Проверка файловой системы — хороший дополнительный контроль, но она не всегда понимает, что архив неполный или приложение завершило задание с ошибкой.
Стандартные item keys помогают обойтись без скриптов
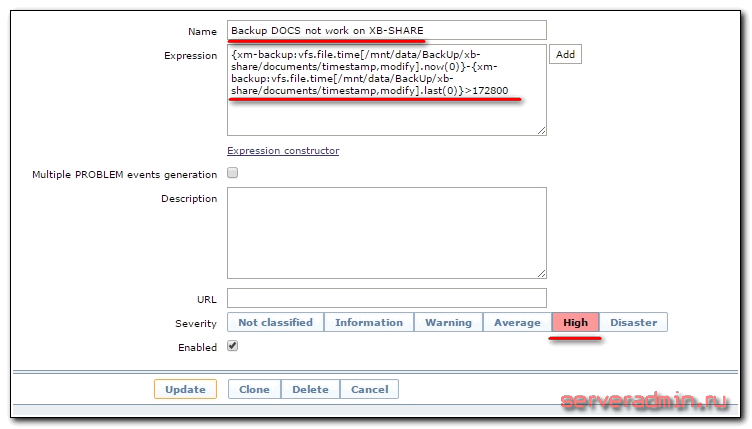
В старой реализации создавался отдельный item для контроля backup и отдельный trigger на проблему. Интерфейс Zabbix изменился, но сама схема «метрика → item → trigger» остаётся той же.
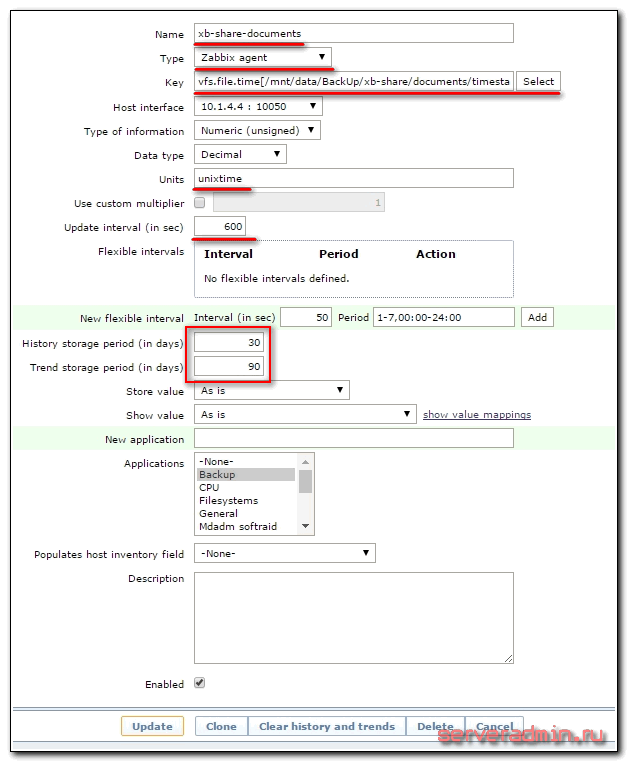
Для обычного файла Zabbix Agent умеет проверять существование, размер и время изменения через vfs.file.exists[], vfs.file.size[] и vfs.file.time[]. Custom UserParameter нужен только там, где требуется логика поверх нескольких файлов, API удалённого storage или статус конкретной backup-системы.
Триггер «нет свежего бэкапа» важнее «файл существует»
Если backup хранится как набор однотипных каталогов и архивов, сначала зафиксируйте реальную структуру repository. Именно от неё зависит логика discovery, поиска последнего файла и проверки возраста.
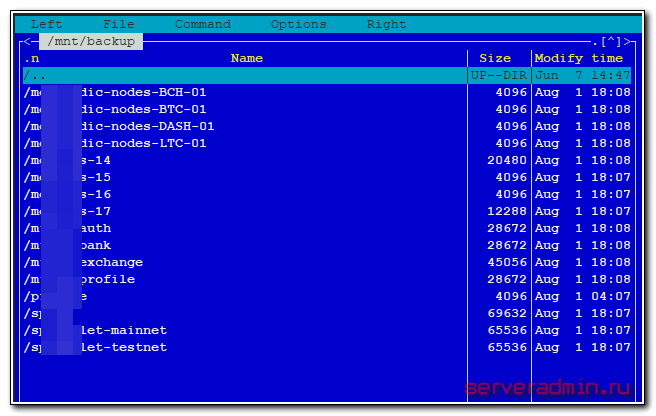
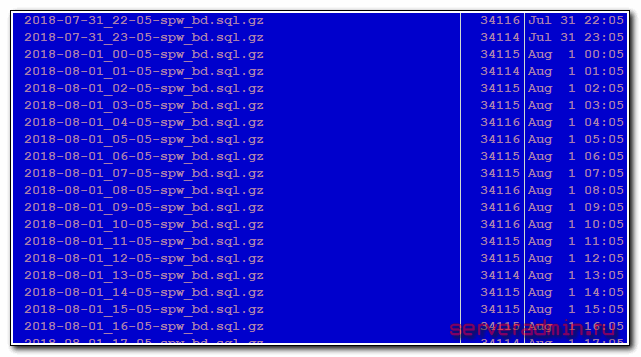
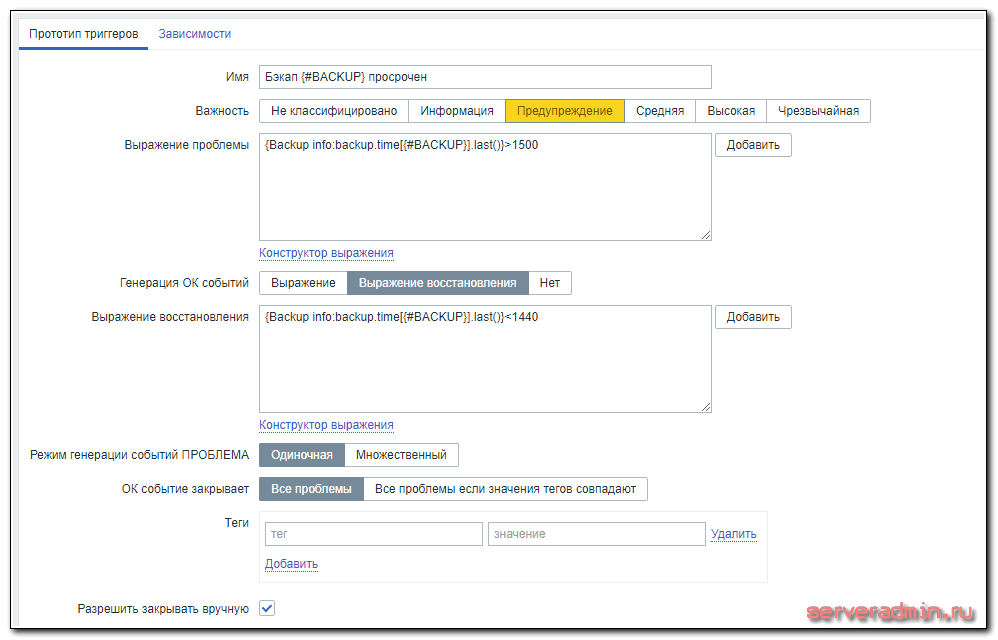
Старый успешный архив может лежать месяцами и создавать иллюзию защиты. Сравнивайте timestamp последней копии с ожидаемым RPO: если ежедневный бэкап старше допустимого окна, проблема должна срабатывать независимо от наличия файла.
Контролируйте изменение размера
Для большого числа однотипных backup-наборов удобно использовать low-level discovery и прототипы items/triggers. В старом шаблоне отдельно контролировались возраст и размер каждого обнаруженного архива.
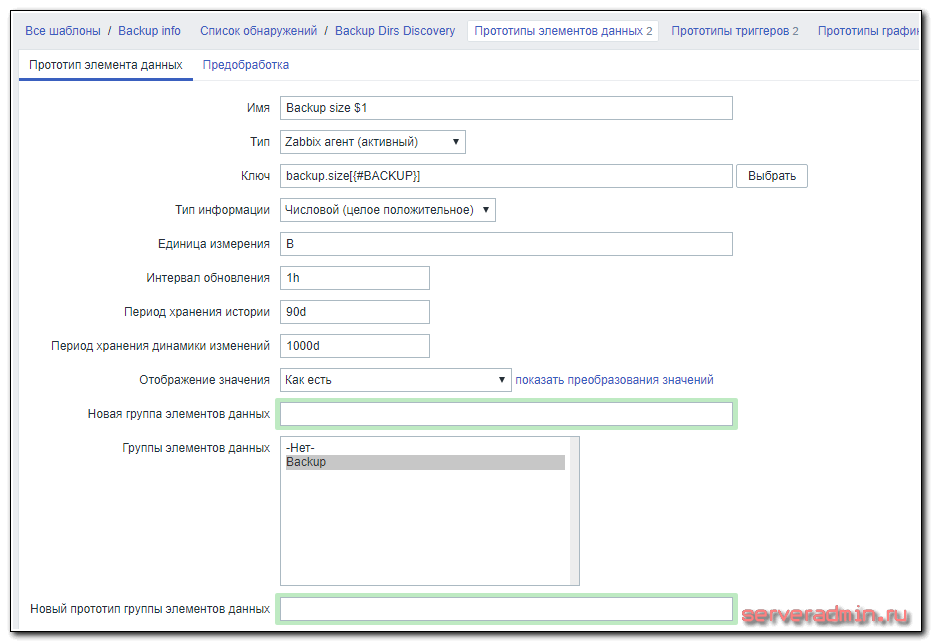
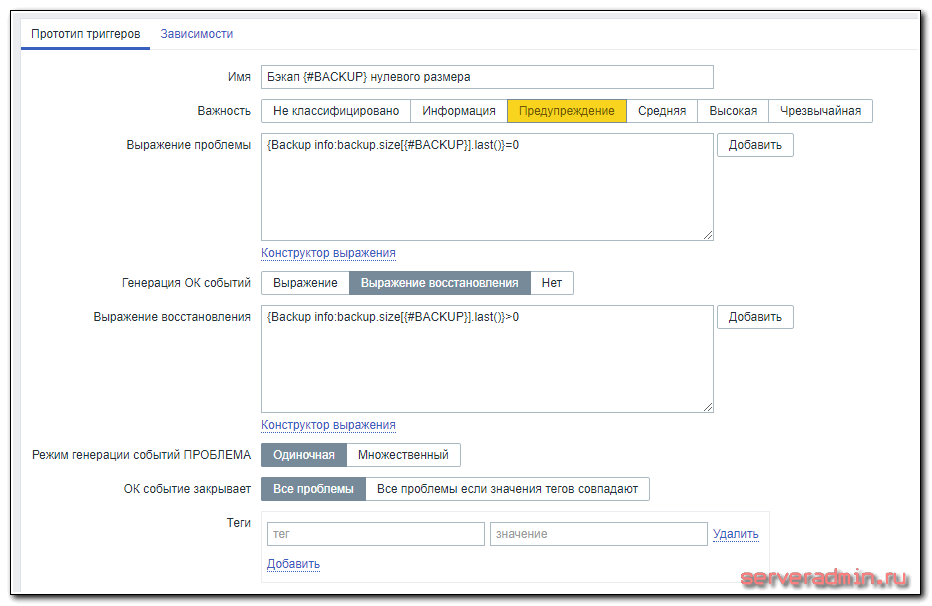
Абсолютный порог полезен, но ещё полезнее динамика. Если типичный архив 20–25 ГБ внезапно стал 300 МБ, формально он существует и свежий, однако это сильный признак неполной копии. Порог отклонения подбирайте по истории конкретной системы.
Свободное место и retention
Мониторьте хранилище отдельно. Переполненный диск часто ломает следующий backup job раньше, чем это заметят пользователи. Политику удаления старых копий лучше реализовать в самой backup-системе, а Zabbix использовать для контроля того, что retention действительно работает.
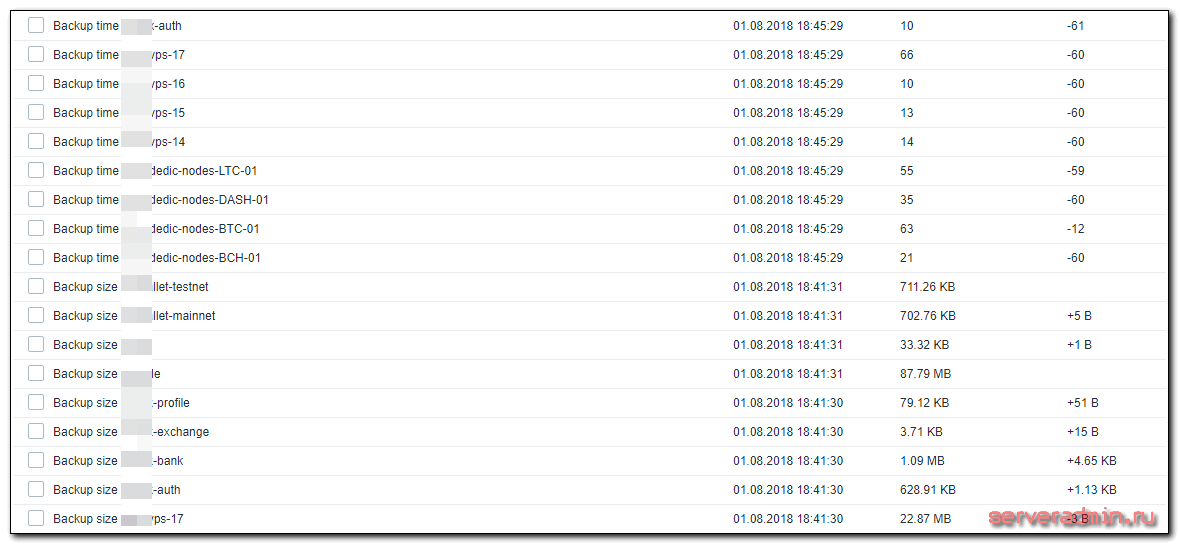
После привязки шаблона обязательно проверьте, что данные действительно поступают по каждому обнаруженному backup-набору. Старый пример ниже показывает итоговый вид такой проверки.
Restore-test превращает бэкап в проверенную копию
Периодически восстанавливайте выборочный файл, дамп базы или тестовую VM в отдельное место и передавайте результат проверки в Zabbix. Это единственный способ убедиться не только в наличии архива, но и в его пригодности к восстановлению.
Итог: хороший мониторинг бэкапов — это несколько независимых проверок. Свежесть, размер, exit code, место на storage и restore-test вместе дают гораздо более честный статус, чем один зелёный item.