Веб-сервер может отвечать на TCP-порт и при этом работать плохо: запросы зависают, PHP-FPM упирается в лимит процессов, растёт очередь или backend начинает отдавать 5xx. Поэтому полезный мониторинг веб-стека должен смотреть не только доступность порта, но и внутренние метрики сервисов.
Nginx: начните с официального шаблона
Сначала проверьте сам stub_status локально, затем убедитесь, что его может получить Zabbix agent/HTTP check. Старые скриншоты ниже показывают именно эту последовательность.
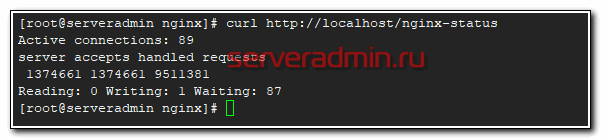
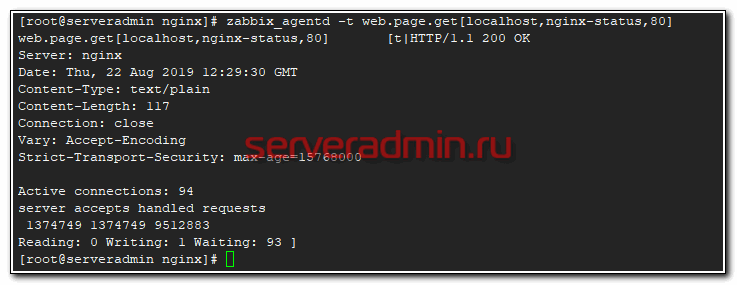
Раньше для этого импортировался отдельный самодельный шаблон. Сегодня лучше начать с официального template, но структура остаётся знакомой: items, triggers и проверка Latest Data.
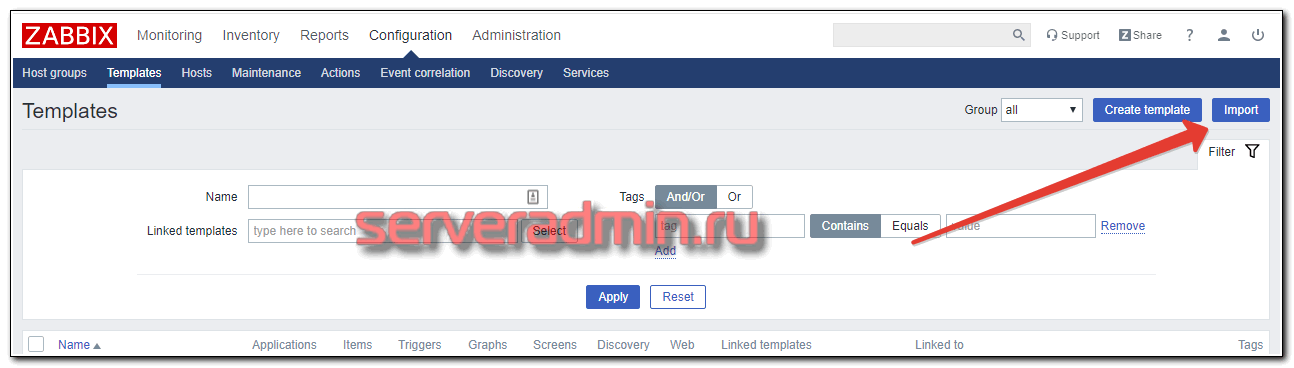
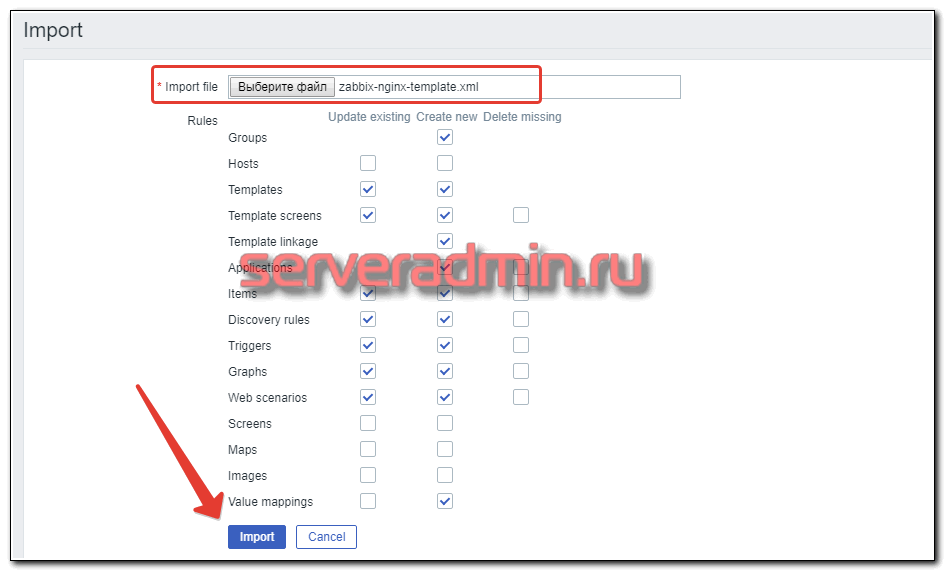


В актуальных версиях Zabbix есть официальные шаблоны для Nginx через agent и HTTP. Они используют stub_status и позволяют получать число активных соединений, запросы, accepted/handled connections и состояние процесса.
location = /basic_status {
    stub_status;
    allow 127.0.0.1;
    deny all;
}
Не публикуйте status endpoint в интернет без ограничений. Для удалённого HTTP-шаблона разрешите доступ только с адреса Zabbix Server/Proxy.
Apache: используйте server-status и готовый template
Для Apache сначала проверьте server-status?auto, а затем уже подключайте template. В старом варианте отдельно настраивались items и macros для URL status-page.
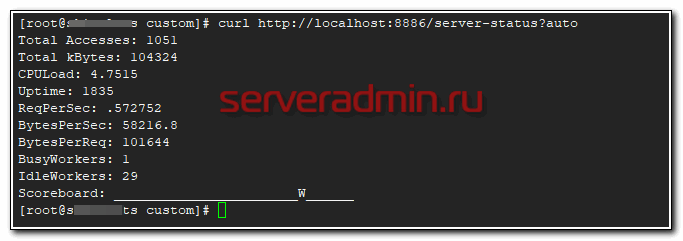

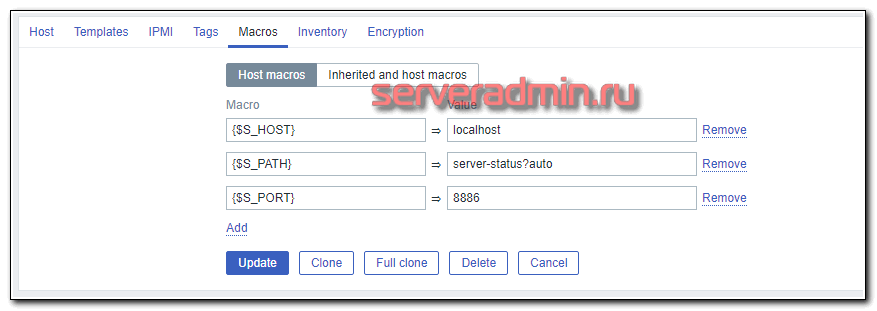

Для Apache также есть официальные шаблоны. Они дают более полезную картину, чем проверка процесса: занятые workers, запросы, uptime и другие показатели, которые позволяют увидеть деградацию до полного отказа сайта.
PHP-FPM: контролируйте пул, а не только процесс php-fpm
Проверка начинается с локальной status-page PHP-FPM. После этого метрики можно передавать в Zabbix и убедиться, что они появляются в Latest Data.
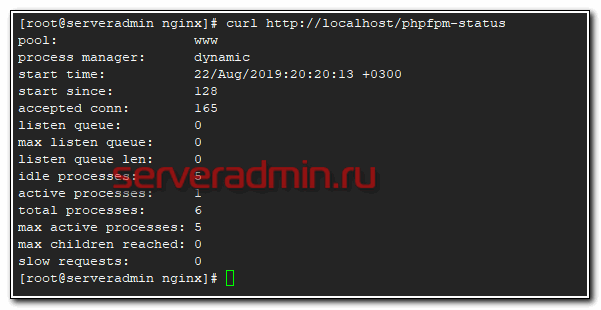

Для PHP-FPM важны active/idle processes, total processes, очередь и достижение pm.max_children. Источником обычно служит status page PHP-FPM, доступная только локально или через служебную сеть. Метрики можно забирать HTTP Agent, Zabbix Agent или своим шаблоном.
Какие триггеры действительно полезны
- сервис недоступен;
- время ответа выросло выше нормального;
- растёт доля 5xx;
- Nginx/Apache начинает сбрасывать соединения;
- PHP-FPM регулярно достигает лимита процессов;
- очередь PHP-FPM не возвращается к нулю;
- процесс перезапускается чаще обычного.
Dashboard и сравнение производительности
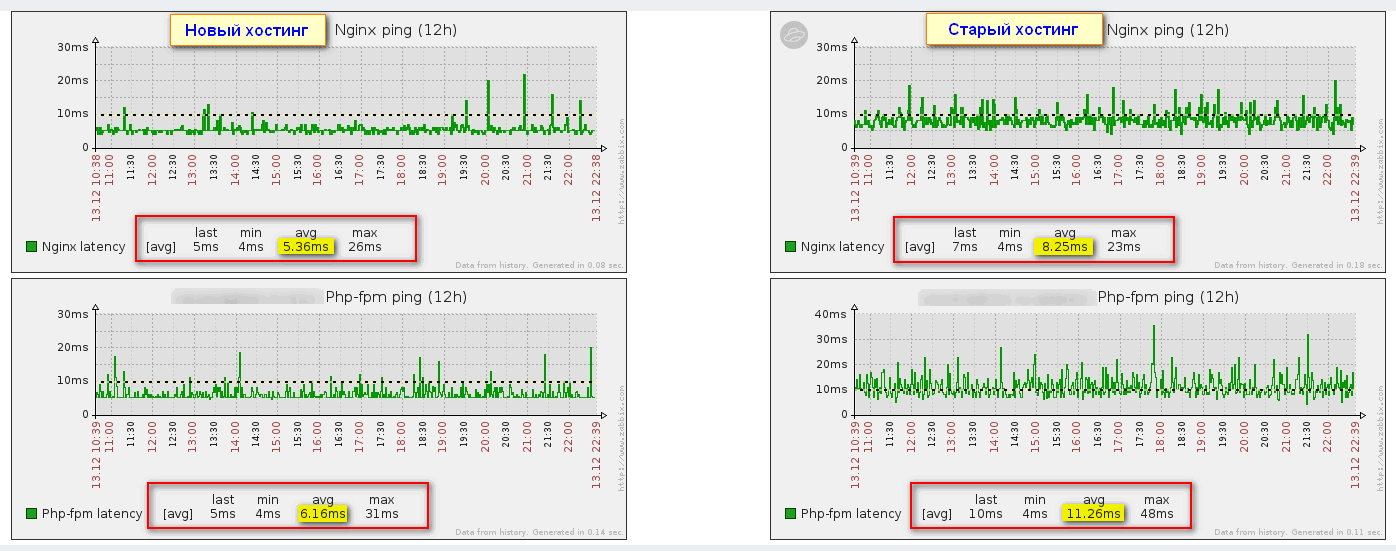
Когда Nginx, PHP-FPM, Apache, backup и системные метрики собраны вместе, их удобно свести на один dashboard. Старый пример ниже показывает именно такую сводную картину веб-сервера.

Исторические данные позволяют сравнивать не только аварии, но и производительность разных площадок. В исходном кейсе графики времени ответа использовались для сравнения старого и нового хостинга.
Разделяйте мониторинг сервиса и сайта
Метрики Nginx или Apache показывают состояние веб-сервера, но не гарантируют, что конкретный сайт работает. Дополните их Web Scenario или HTTP-проверкой реального URL с ожидаемым статусом и, при необходимости, содержимым ответа.
После обновления Zabbix проверяйте шаблоны
Встроенные шаблоны не всегда обновляются автоматически вместе с сервером, чтобы не затереть локальные изменения. После обновления Zabbix имеет смысл сравнить используемые шаблоны с актуальными шаблонами для вашей ветки.
Итог: для Nginx и Apache лучше начинать с официальных templates, а PHP-FPM добавлять как отдельный слой. В результате триггер говорит не просто «порт 80 открыт», а показывает, где именно узкое место: веб-сервер, PHP-пул или само приложение.