Логи Nginx в Kibana: Elastic Agent, dashboard и полезные метрики
Dashboard по Nginx полезен только тогда, когда он отвечает на практические вопросы: сколько запросов получает сайт, где растут 4xx/5xx, какие URI самые медленные и что происходило перед аварией. Поэтому начинать стоит не с красивых графиков, а с корректного сбора access и error logs.
Современная схема сбора
Для актуального Elastic Stack удобнее использовать Nginx integration через Elastic Agent. Интеграция умеет собирать access/error logs и метрики Nginx, а данные раскладываются по data streams. Это надёжнее, чем вручную поддерживать старый Filebeat module и собственный набор grok-фильтров без необходимости.
GeoIP: сначала проверьте mapping
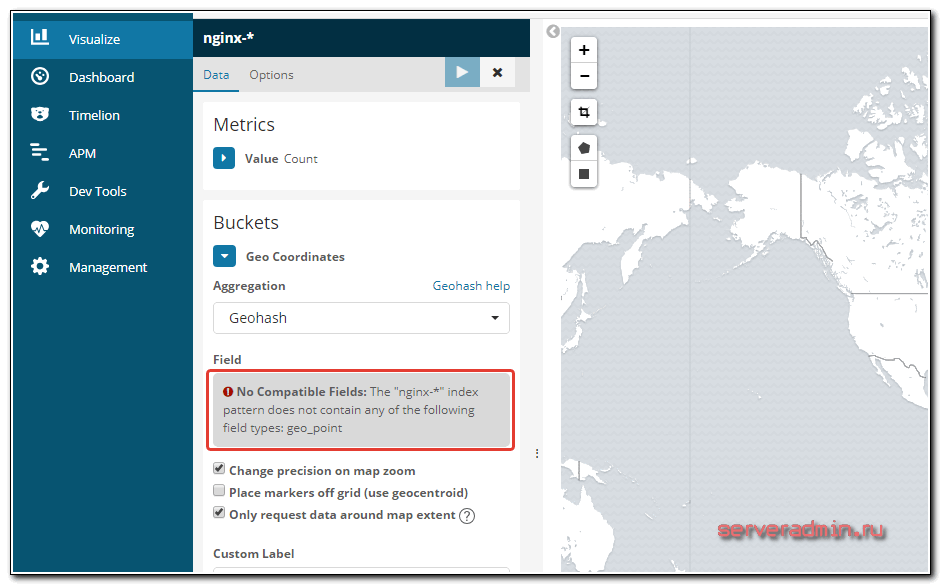
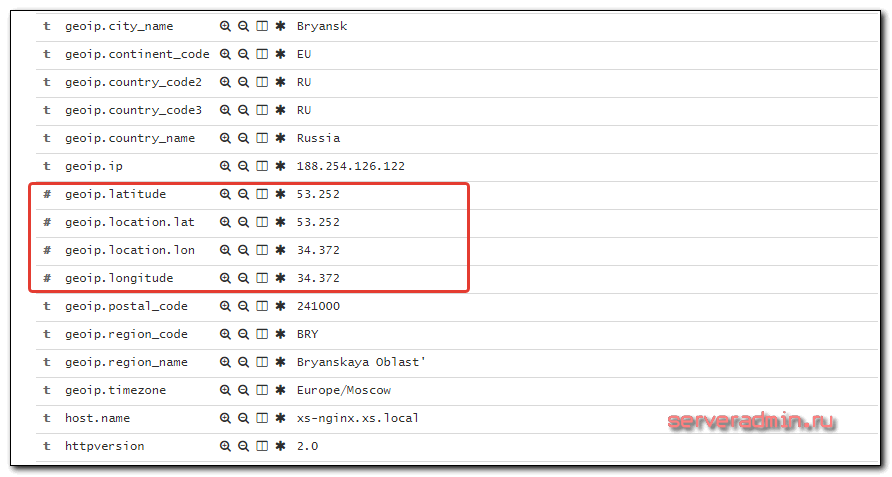
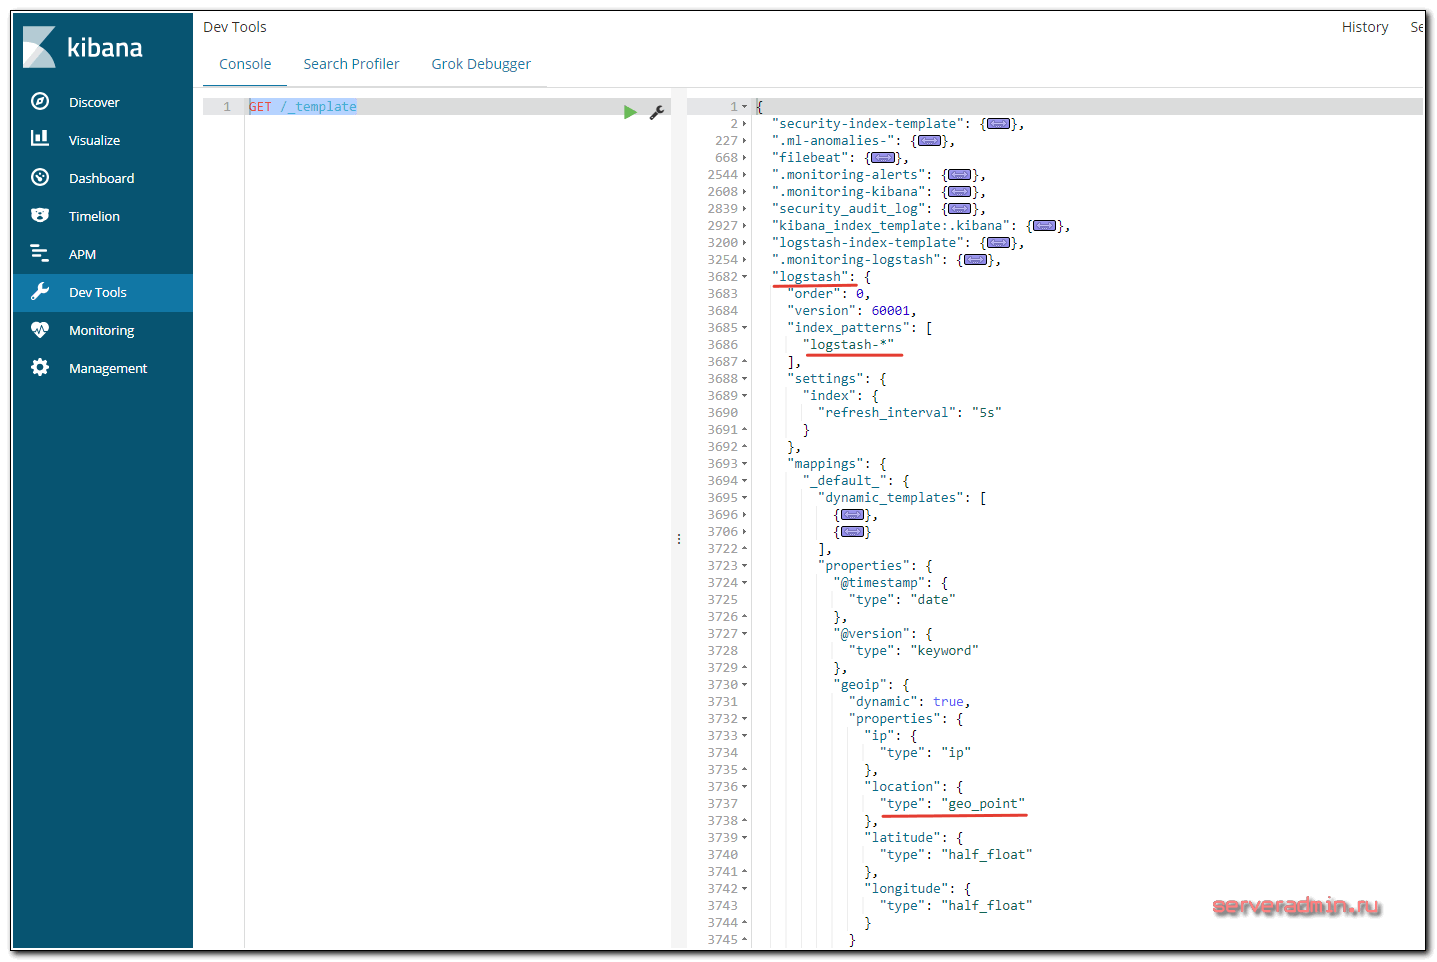
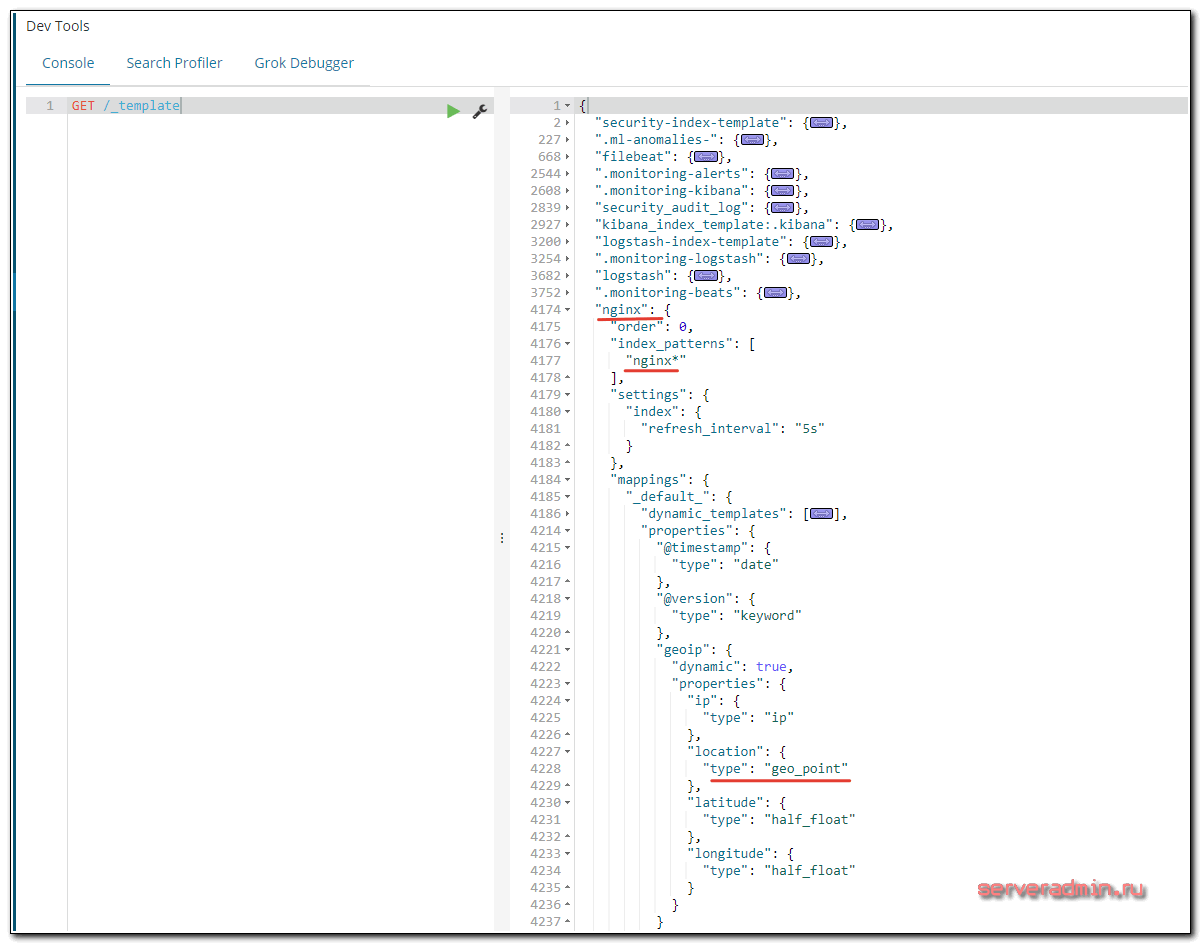
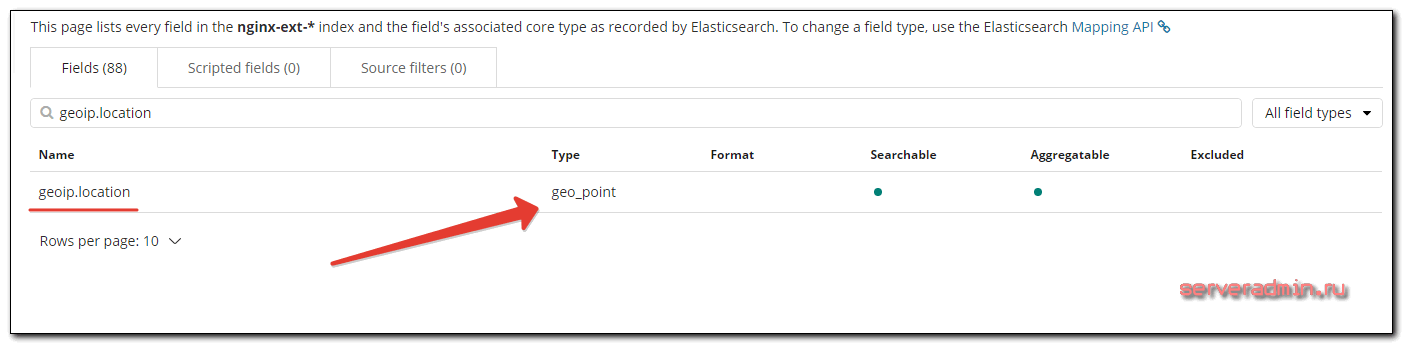
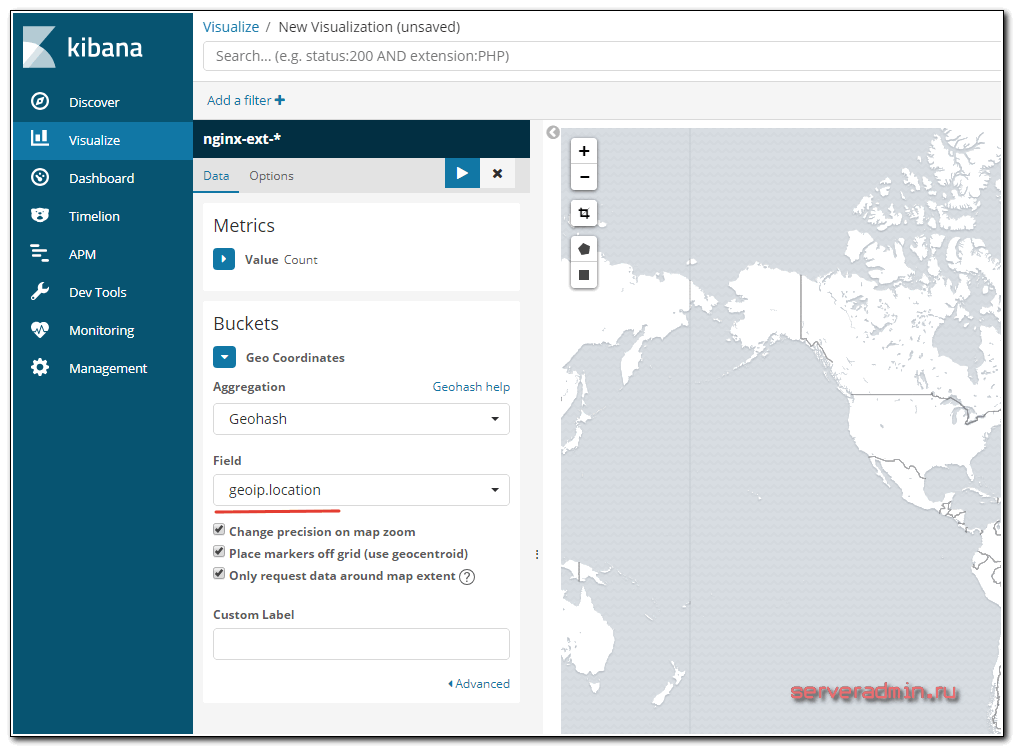
В старой Kibana одна из типичных проблем с картой выглядела как ошибка No Compatible Fields: координаты в документе есть, но поле проиндексировано не как geo_point. Скриншоты ниже показывают именно такой случай — от ошибки до проверки mapping.
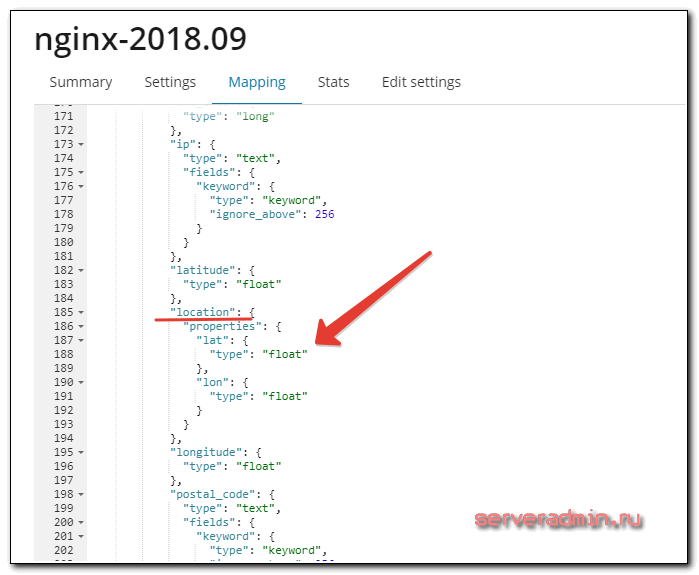
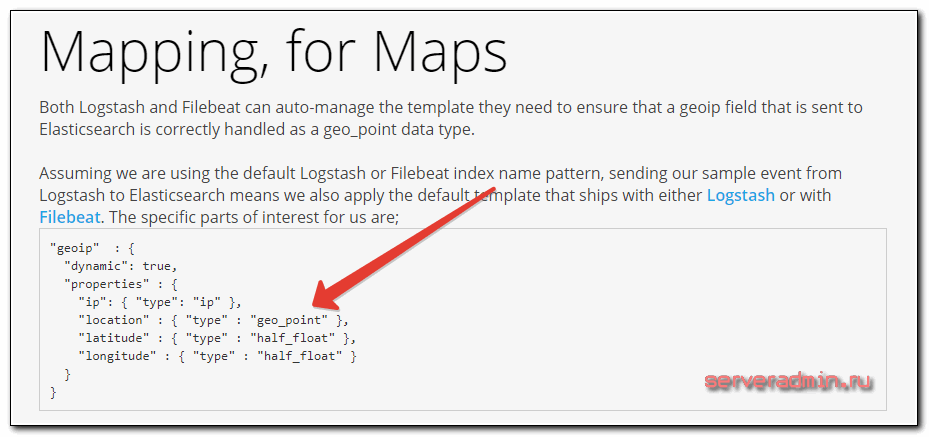
Тип поля нельзя безопасно «переобуть» задним числом в уже созданном индексе. В старой схеме это решалось шаблоном индекса для будущих индексов.
Какие данные нужны для полезного dashboard
- HTTP status;
- request method;
- URI или route;
- response time;
- bytes sent;
- client IP;
- user agent;
- host/server name;
- исходное error message.
Если используете собственный log_format, убедитесь, что он содержит нужные значения. При изменении формата проверьте, продолжает ли ingest pipeline корректно разбирать строки.
Что вывести на первую страницу Kibana
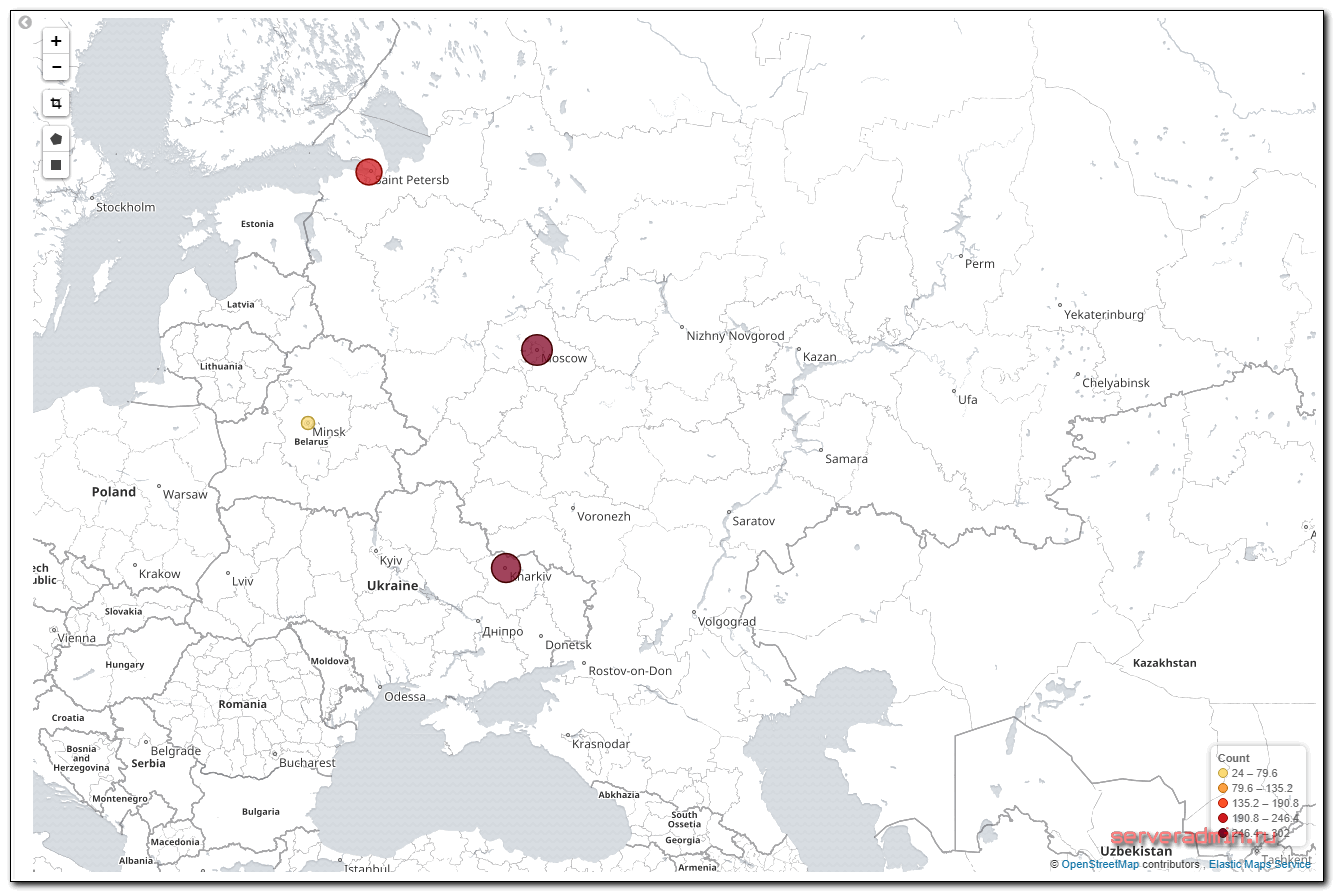
Если в логах есть корректный GeoIP, карту можно добавить как одну из визуализаций. В старой Kibana для этого использовалась Coordinate Map с полем geoip.location.
- Количество запросов по времени.
- Доля 2xx, 3xx, 4xx и 5xx.
- Топ URI по числу запросов.
- Топ URI по 5xx.
- Распределение response time и p95/p99, если поле доступно.
- Топ клиентских IP и user agents.
- Последние error log события.
Почему один средний response time мало полезен
Среднее значение легко скрывает редкие, но тяжёлые задержки. Лучше смотреть медиану и высокие процентили, а затем проваливаться до конкретного URI или временного диапазона. Если latency выросла только у одного backend-route, глобальный график может выглядеть почти нормально.
4xx и 5xx нужно разделять
Большое число 404 может быть результатом ботов или устаревших ссылок, а всплеск 502/504 чаще указывает на проблемы upstream. Не смешивайте их в один красный график. Для 5xx полезно группировать события по URI, upstream и server name.
Алерты, которые действительно помогают
- рост доли 5xx выше обычного уровня;
- серия 502/504 за короткий интервал;
- резкий рост latency;
- исчезновение логов от production-хоста;
- аномальный всплеск запросов к одному URI;
- быстрый рост объёма access logs.
Следите за временем и timezone
Некоторые форматы Nginx не несут явную timezone в каждой строке, поэтому агент использует локальную временную зону при разборе и приводит timestamp к UTC. Если сервер и агент работают в разных временных зонах, отдельно проверьте это в тестовом событии — иначе корреляция с приложением и базой данных будет сбиваться.
Пример итогового dashboard
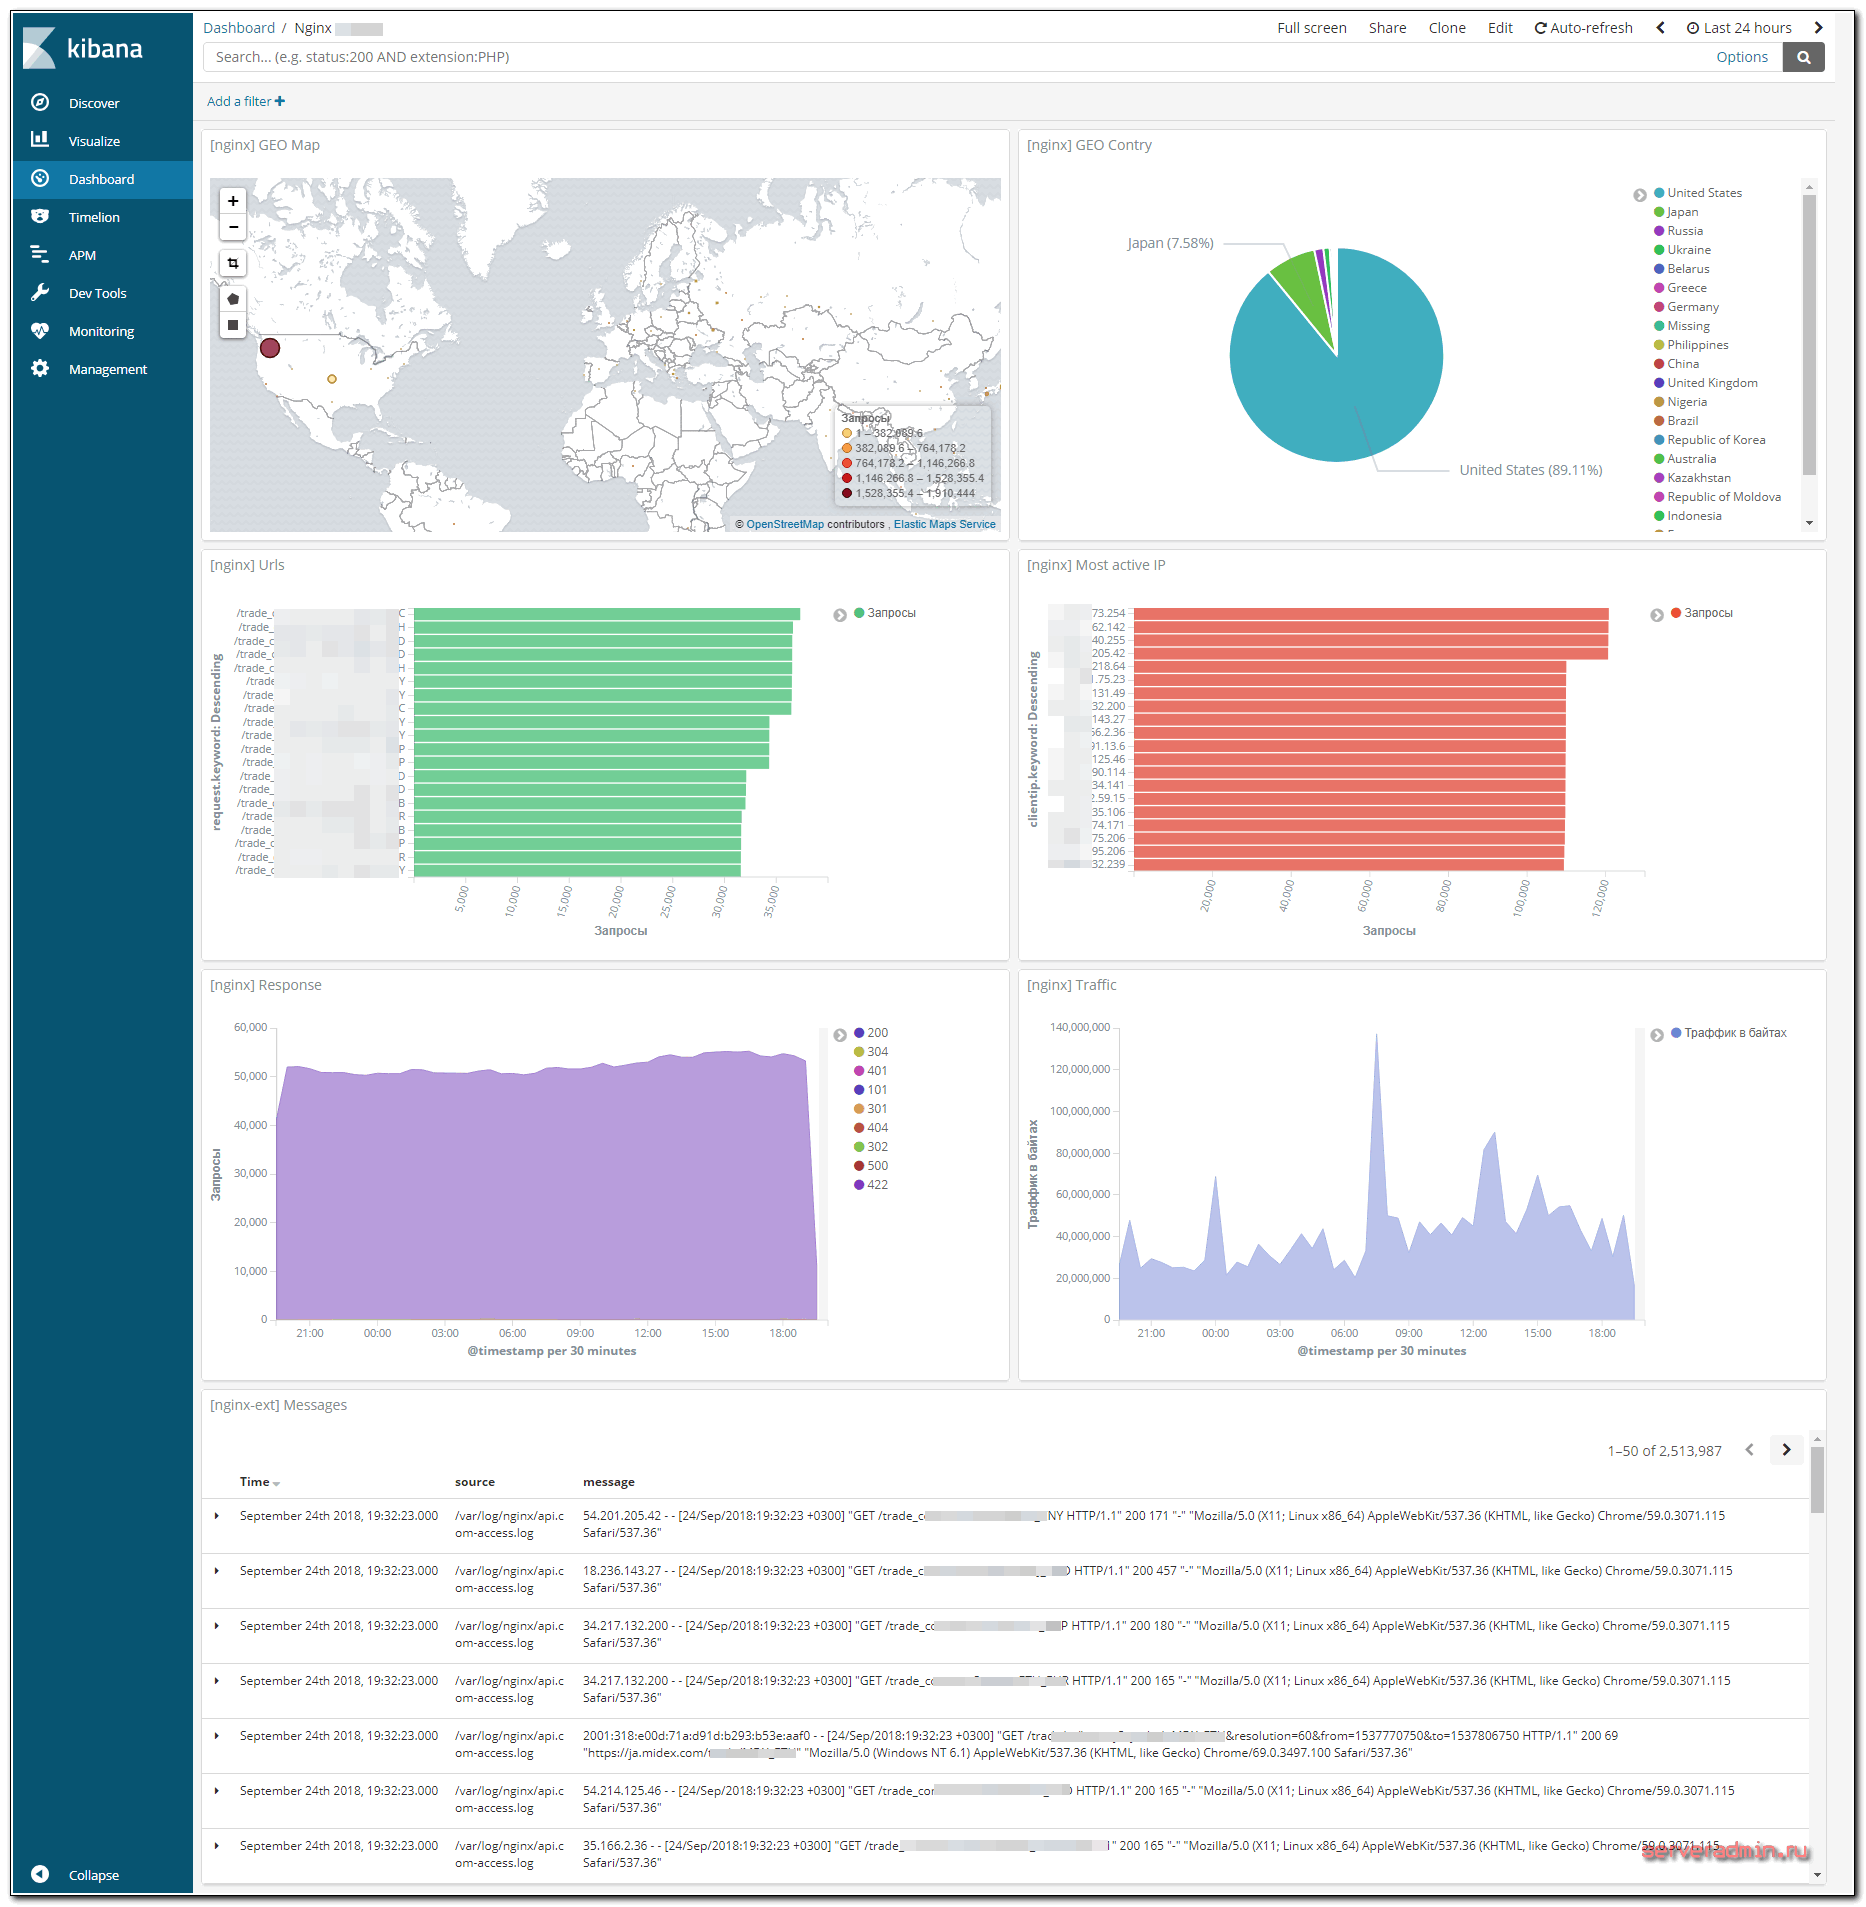
В исходном материале после нескольких итераций получился dashboard с картой, временными графиками, статусами и другими срезами по Nginx. Интерфейс Kibana с тех пор сильно изменился, но сам принцип остаётся полезным: на одном экране должны быть только те визуализации, которые помогают быстро найти источник проблемы.
Не превращайте Kibana в хранилище вечных логов
Access logs очень быстро растут. Задайте retention через lifecycle, чтобы хранить подробные данные столько, сколько действительно нужно. Для более долгой истории часто достаточно агрегированных метрик и алертов.
Итог: хороший Nginx dashboard — это не десятки виджетов, а несколько графиков, которые быстро отвечают на вопросы о нагрузке, ошибках и задержках. Сначала добейтесь корректных полей и стабильного ingest, затем стройте визуализации.