Elasticsearch: ошибка FORBIDDEN/12 index read-only / allow delete — причины и правильное восстановление
Ошибка FORBIDDEN/12/index read-only / allow delete обычно означает не «сломанный индекс», а защитную реакцию Elasticsearch на нехватку дискового пространства. Если просто снять блокировку и ничего не изменить, она может появиться снова.
Сначала проверьте место на диске
Начните с файловой системы на всех data nodes. Проверьте не только проценты, но и абсолютный свободный объём, потому что крупный shard может потребовать значительный запас для merge, relocation или восстановления.
df -hПочему Elasticsearch блокирует запись
Так эта проблема выглядела в старом Elastic Stack: индекс переставал принимать новые документы, а в интерфейсе/логах появлялась ошибка FORBIDDEN/12/index read-only / allow delete (api). Скриншот ниже оставлен как пример симптома — лечить нужно причину с диском, а не только сам флаг.
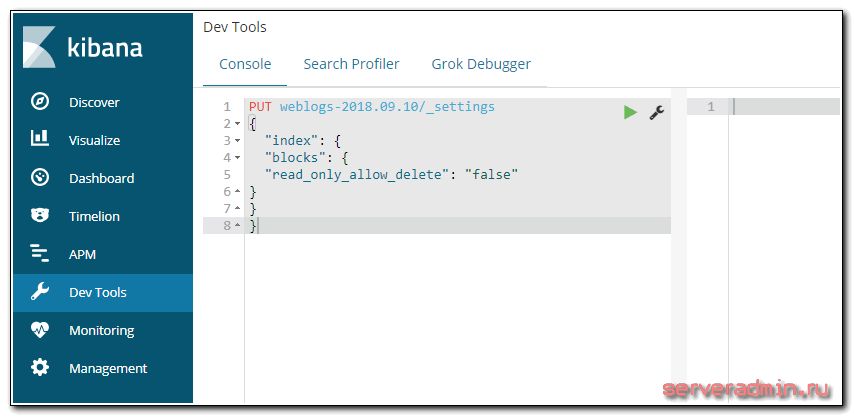
При достижении критического disk watermark Elasticsearch может установить на затронутые индексы блок index.blocks.read_only_allow_delete. Это даёт возможность удалять данные, но ограничивает операции, которые способны ещё сильнее заполнить диск.
Освободите место до снятия блока
- удалите действительно ненужные старые данные через предусмотренную lifecycle-политику;
- проверьте snapshots и локальные временные файлы вне Elasticsearch;
- при необходимости увеличьте диск или добавьте ёмкость кластеру;
- не удаляйте вручную файлы shard из data directory.
Проверьте состояние кластера
После освобождения места убедитесь, что nodes снова находятся ниже критических порогов и shards не застряли в relocation. Если кластер всё ещё перегружен, снятие блока само по себе проблему не решит.
Снятие read_only_allow_delete
Когда причина устранена, блок можно снять через index settings. В разных версиях и конфигурациях конкретный запрос лучше сверять с документацией вашей версии Elasticsearch. Не превращайте это действие в cron-задачу: автоматическое снятие блока скрывает проблему с ёмкостью.
Как не получить ошибку снова
Настройте retention/data lifecycle, алерт на свободное место, контроль темпа ingest и прогноз роста. Для логового кластера это намного важнее периодической ручной очистки, когда диск уже почти заполнен.